Guide
Faire une vidéo faceless avec Claude Code
Tu ne veux pas te montrer. Ta voix suffit : le reste, un agent sait le faire. Un plateau, tes visuels posés sur les mots, et si tu veux, un personnage qui change de tête au fil de tes phrases. Voici la méthode, les outils, et ce qu’ils coûtent vraiment, sans générateur vidéo payé à la seconde.
Par Vincent Ventalon · Mis à jour le
Ce qu’est une vidéo faceless, et ce qu’elle n’est pas
Faceless, c’est « sans visage » : une vidéo où personne n’apparaît à l’écran. Ce qui retient quelqu’un qui scrolle, ce n’est pas une tête : c’est une idée, un rythme, et une image qui bouge au bon moment. Trois familles couvrent presque tout ce qu’on voit passer :
-
Ta voix sur tes visuels
Un mémo vocal, et à l’écran des captures, des images, des cartes de texte, un schéma, posés sur les mots qui les appellent. C’est la forme la plus simple, et la plus courante.
-
Une capture d’écran commentée
Tu enregistres ton écran en parlant : une démo, un tuto, un site qu’on parcourt. La capture est le visuel, la voix fait le reste.
-
Ta voix et un personnage
Un personnage joue la vidéo à ta place : il change d’expression au fil de tes phrases, il regarde ce qu’on montre, il s’efface devant une grande illustration.
Ce qu’on ne fait pas ici L’avatar généré en vidéo, qui parle avec ta voix clonée. Les outils qui le font facturent à la seconde de vidéo produite, chaque reprise coûte, et le visage dérive d’une génération à l’autre. Tout ce guide tient sur ton abonnement Claude, des images fixes et ffmpeg.
La méthode, en cinq étapes
C’est la même chaîne que pour une vidéo face caméra, celle du guide du montage avec Claude Code. Une seule chose change : il n’y a pas d’image au départ, il faut la fabriquer.
- 01
Enregistrer ta voix, d’un trait
Le dictaphone de ton téléphone, dans une pièce calme. Parle comme si tu filmais : tu peux te reprendre, hésiter, recommencer une phrase. C’est au tri de garder la dernière prise complète, pas à toi de produire un enregistrement propre. Un mémo vocal de trois minutes donne une vidéo d’une minute.
Le piège Lire un texte à voix haute s’entend. Écris des idées, pas des phrases, et dis-les. Si tu as besoin d’un texte, un prompteur qui suit ta voix vaut mieux qu’une feuille.
- 02
Transcrire mot à mot, puis trier les prises
Chaque mot avec son instant, faux départs compris : Whisper en local si tu ne veux pas payer, ElevenLabs Scribe sinon. Puis Claude lit le texte, repère les phrases redites, et écrit la liste de ce qu’il retire. Un fichier sans visage ne change rien à cette étape : c’est du texte.
Le détail qui compte : garde ce qui a été retiré lisible quelque part, pour le remettre si la coupe était fausse. L’oreille reste la tienne.
- 03
Fabriquer le plateau
Le plateau, c’est une vidéo verticale, un fond uni, et ta voix dessus. Rien d’autre. Tout ce qui suit le lit comme s’il s’agissait d’un rush : les coupes, les sous-titres, les visuels, le rendu. Une capture d’écran, elle, se pose entière au milieu du plateau, jamais recadrée.
Un plateau en une commande : un fond sombre, la voix, la durée du son $ ffmpeg -f lavfi -i "color=c=0x15171C:s=1080x1920:r=30" \ -i memo.m4a -shortest -c:v libx264 -pix_fmt yuv420p -c:a aac plateau.mp4Le piège Un fond chargé (une texture, un dégradé animé) se bat avec les visuels. Un fond uni sombre, et la couleur de ton style pour les cartes et les mots qui comptent : c’est ce qui se lit sur un téléphone.
- 04
Poser les visuels sur les mots
C’est l’étape qui fait la vidéo. Claude lit le transcript et décide, phrase par phrase, ce qui s’affiche : une capture quand tu nommes un outil, une carte de texte quand tu donnes un chiffre, une image quand tu racontes une scène, le titre du haut sur le premier visuel, celui que la grille du profil montre. Chaque plan est ancré sur un mot, à l’instant près.
- Jamais plus de deux ou trois secondes de plateau nu. Un fond vide, c’est le moment où on scrolle.
- Un visuel par idée dite, pas un par mot. Trois gros éléments au plus à l’écran, sous-titres compris.
- Un mot appuyé à l’oral s’écrit en grand, seul. Une capture reste assez longtemps pour être lue.
Le piège Laissé libre, un agent invente des effets différents à chaque vidéo. Donne-lui un catalogue : plein cadre, carte, planche, et pour chacun où va le contenu et où passent les sous-titres. Il choisit parmi, il ne dessine pas.
- 05
Rendre, puis contrôler
Le rendu TikTok et Instagram, les sous-titres incrustés, la musique en lit. Puis des contrôles écrits une fois : la durée, le son, un plateau nu de plus de trois secondes signalé, une image fixe par plan pour vérifier à l’œil ce que Claude ne voit pas défiler.
Le personnage, si tu en veux un
Le plateau et des visuels suffisent à une vidéo faceless. Un personnage ajoute quelqu’un à regarder : il réagit à ce que tu dis, il donne une identité au compte. Il se fabrique une fois, et sert ensuite à toutes tes vidéos. Trois façons d’obtenir ses images :
Trois façons de le fabriquer
- Des images générées. Tu décris le personnage (qui il est, son style, ses couleurs, sa tenue, un signe distinctif), un générateur produit sa planche de référence, puis ses poses, chacune avec la planche en référence. Le plus expressif. Le fond est demandé uni, puis retiré, pour obtenir des PNG transparents.
- Un personnage en code. Claude l’écrit en SVG : un blob, deux yeux, une bouche, une antenne. Il cligne, il respire, il change d’humeur, sa bouche peut suivre ta voix. Rien à générer, rien à payer, et il est strictement identique d’une vidéo à l’autre. Moins de variété qu’un dessin, un style « motion design ».
- Tes propres images. Un dessin à toi, ta photo découpée façon collage, une mascotte que tu as déjà. Tu la déposes, Claude en fait les variantes à partir d’elle. C’est aussi la voie de secours quand tu n’as aucun outil d’image : il écrit le texte, tu le colles dans l’app gratuite de ton choix, tu rends l’image.
Les outils d’image, et ce qu’ils coûtent
-
Codex, sur ton abonnement ChatGPT rien de plus
L’agent d’OpenAI génère des images sur un abonnement Plus ou Pro, sans clé, avec tes images de référence. Compte une à trois minutes par image, sur ton quota. Pas sur le plan gratuit. Si une clé API OpenAI traîne dans ton terminal, il facturera l’API à la place : retire-la.
-
Une clé Gemini (Nano Banana) moins d’un euro le personnage
Environ 7 centimes l’image par l’API de Google, avec des images de référence. Un personnage complet, planche et douze poses, tient sous un euro. Pas de palier gratuit à l’API pour l’image.
-
L’app Gemini ou ChatGPT, à la main gratuit
Claude écrit le texte de chaque image, tu le colles dans l’app, tu déposes le fichier qu’elle te rend. L’app Gemini gratuite donne une vingtaine d’images par jour : assez pour un jeu de poses en une soirée.
-
Grok, sur un abonnement X ou SuperGrok un abonnement à part
La voie de beaucoup de créateurs faceless francophones : la ligne de commande de xAI génère des images sur l’abonnement. Je ne l’ai pas testée : elle demande un abonnement de plus.
-
Dessiné en code par Claude gratuit
Un personnage en SVG : des formes, deux yeux, une bouche, écrit par Claude et animé par lui (il cligne, il respire, sa bouche bouge sur ta voix). Identique à chaque vidéo, par construction. Moins expressif qu’un dessin généré, mais il bouge, et il ne coûte rien.
Mon conseil : Codex si tu as déjà ChatGPT Plus, une clé Gemini sinon, l’app à la main si tu ne veux rien payer. Le SVG quand tu veux quelque chose de simple qui ne bouge jamais d’une vidéo à l’autre.
La planche de référence d’abord, les poses ensuite
La seule chose qui tient un personnage d’une image à l’autre, c’est une image de référence repassée à chaque génération, en ne changeant que la pose et l’expression. Fabrique donc d’abord une planche : lui de face, de trois quarts, de profil, et quatre têtes avec des expressions. Regarde-la, corrige-la, valide-la. Ensuite seulement, les poses : huit à douze, nommées par ce qu’elles expriment (explique, montre, surpris, content, réfléchit, doute, compte, non, rit), en corps entier et en tête seule. Une grille de poses générée en une passe garde mieux l’identité que douze images séparées.
Le piège Le personnage qui change de tête d’une pose à l’autre. Ça vient toujours d’une génération sans référence, ou d’une description qui change entre deux images. La planche en référence, et une seule fiche qui décrit le personnage, résolvent les deux.
Le monter : une pose par phrase
Au montage, le personnage est un visuel comme les autres, ancré sur un mot. Les règles qui le rendent vivant sans l’animer :
- Une expression par phrase, posée au début de la phrase qui la justifie, et tenue au moins une à deux secondes. Jamais deux changements rapprochés.
- Le personnage regarde ce qu’on montre : retourne-le en miroir quand le visuel est de l’autre côté.
- Quand une grande illustration occupe l’écran, le personnage sort. Jamais les deux en grand en même temps.
- Le buste sort du bas de l’écran, comme s’il émergeait du bord, plutôt que coupé au milieu.
- Deux familles : le corps entier et la tête seule. Alterne selon la place qu’il reste.
- Pas de bouche qui parle image par image. Une pose qui tient, un petit rebond à l’arrivée, et le son fait le reste.
Ce qu’on voit chez ceux qui le font
J’ai regardé une quinzaine de comptes faceless à personnage, en français et en anglais, le 8 novembre 2026. Quatre font exactement ça : un personnage posé qui change de pose sur une voix, devant des visuels. Deux font beaucoup de vues, deux presque aucune, et la différence n’est pas le personnage.
- Le personnage est petit et dans un coin, le visuel est la vedette. Chez le compte Instagram anglophone qui dépasse le million de vues sur ses Reels Claude Code, le buste est en bas à droite et la capture occupe les deux tiers de l’écran. Chez Le Dev ULTIME sur TikTok (245 000 vues sur sa vidéo faceless), le buste sort du bas, ou n’est pas là.
- Une pose par phrase, jamais de bouche qui bouge. En prenant une image toutes les cinq à huit secondes chez les deux, la pose avait changé à chaque fois. Personne ne fait parler le dessin.
- Le personnage sort quand une illustration occupe l’écran. Vu chez tous ceux qui posent un personnage, y compris ceux qui ne marchent pas.
- Les vues viennent du sujet ou de la série, pas du personnage. Les gros scores sont sur « comment je fais ça avec Claude » avec un mot à commenter (21 500 commentaires sur un Reel), ou sur des fictions en épisodes à bonhomme bâton dont le premier épisode fait un ou deux millions. Un personnage soigné sur un sujet sans accroche reste à quelques centaines de vues, avec cent publications.
- Le style qui revient : un sticker à contour blanc épais, cartoon ou 3D douce, sur un fond uni ou papier, le mot fort écrit en grand en haut.
Ce que ça veut dire pour toi : le visuel porte la vidéo, le personnage ponctue. Soigne d’abord ce qui s’affiche sur tes mots. Le personnage arrive après, et il reste dans son coin.
Un exemple réel : trois personnages en trois minutes
Trois personnages fabriqués ce matin avec Codex, sur mon abonnement ChatGPT, pour mesurer. Cinq réponses chacun (qui, style, couleurs, tenue, signe distinctif), la planche de référence demandée telle quelle, premier essai gardé. Trois styles volontairement différents : un sticker plat, un collage papier, une 3D douce.
-
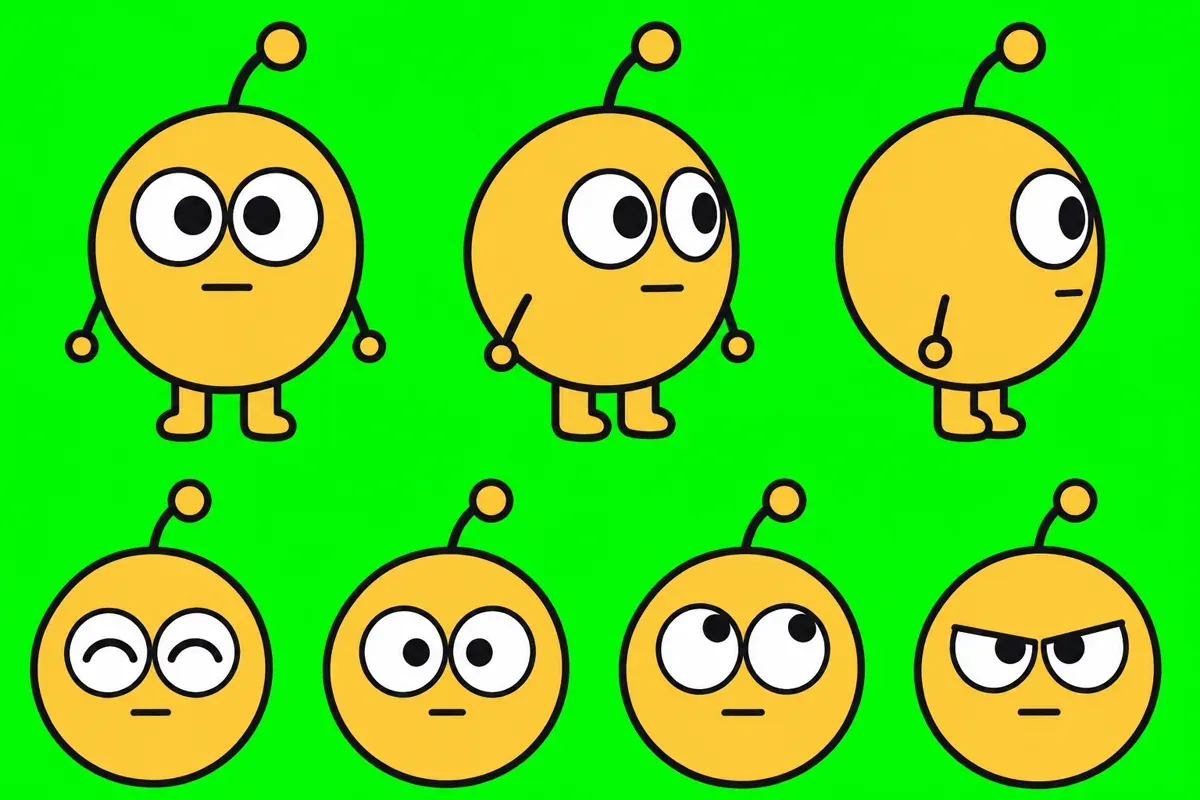
Bip, sticker plat. « Un blob jaune rond, deux grands yeux, des bras bâtons, une antenne. »
-
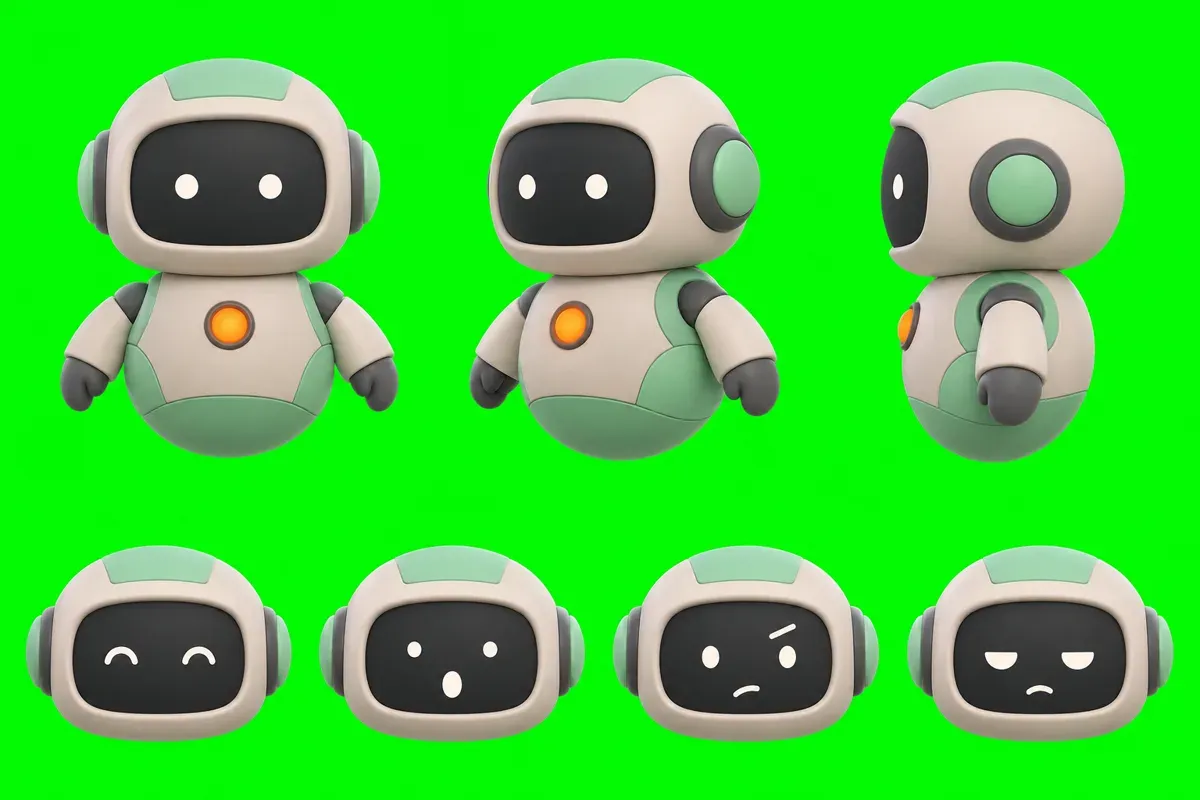
Pixel, 3D douce. « Un petit robot rond, un écran pour visage, un voyant orange sur la poitrine. »
-
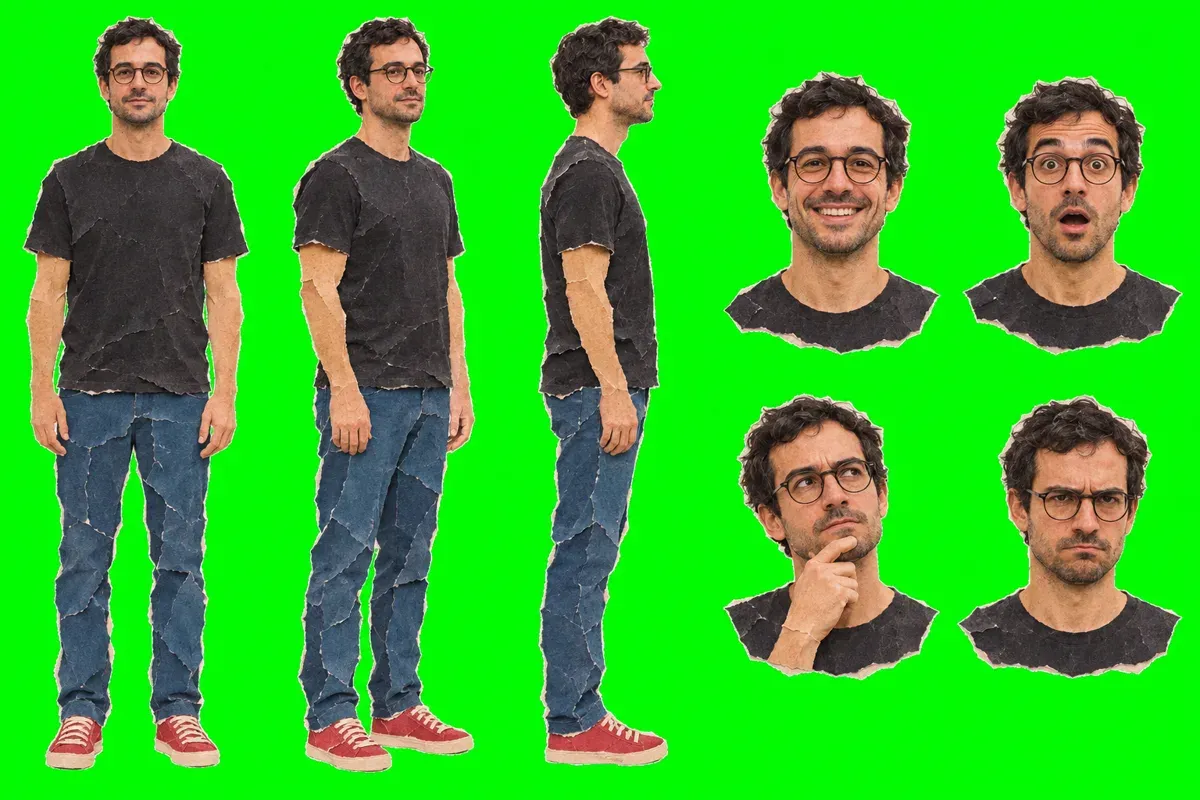
Marcel, collage papier. « Un homme d’une trentaine d’années, lunettes rondes, découpé dans du papier, bords déchirés. »
| Personnages créés | 3 |
|---|---|
| Questions posées à chacun | 5 |
| Temps par planche de référence | ≈ 1 min |
| Essais avant d’obtenir la planche | 1 |
| Poses de Bip, en une grille, même personnage partout | 9 sur 9 |
| Poses détourées proprement du premier coup | 0 sur 9 |
| Coût, sur un abonnement ChatGPT Plus | 0 € |
Le fond vert est voulu : il doit partir ensuite, en local, pour que chaque pose devienne un PNG transparent. La grille de neuf poses de Bip, générée dans la foulée, a tenu le personnage à la perfection, même tête, mêmes proportions, mêmes couleurs, et c’est là que ça a cassé : Codex a remplacé le fond vert demandé par un fond sombre à halo, que le détourage n’a pas su retirer, et sur la pose refaite à part il a mangé le contour noir avec le vert. Le personnage, oui. Le détourage, à régler.
Le piège Vérifie chaque pose posée sur un fond de couleur avant de la ranger. Un halo ou un contour disparu ne se voient pas sur fond blanc, et se voient très bien sur ta vidéo.
Ce que ça coûte, au total
Le même tableau pour chaque façon de faire, outils compris. Les prix sont ceux du 8 novembre 2026.
| La vidéo | Il te faut | Ça coûte |
|---|---|---|
| Ta voix sur tes visuels, sans personnage | Claude Code, ffmpeg, une transcription | ton abonnement Claude ; la transcription gratuite avec Whisper en local |
| Avec un personnage, images par Codex | + un abonnement ChatGPT Plus que tu as déjà | rien de plus |
| Avec un personnage, images par Gemini | + une clé Gemini | moins d’un euro, une fois |
| Avec un personnage, images à la main | + l’app Gemini ou ChatGPT gratuite | rien, une soirée |
| Avec un personnage en SVG | Claude Code seul | rien |
| Ce qu’on ne fait pas : un avatar qui parle, généré en vidéo | un générateur vidéo (Veo, Kling, Hedra…) | plusieurs dollars la minute, à chaque vidéo |
Ce qu’il te faut pour commencer
- Claude Code : avec un abonnement Claude. C’est lui qui écrit le plateau, choisit les visuels, place les poses et lance ffmpeg.
- Un enregistreur : le dictaphone de ton téléphone suffit. Un mémo vocal propre vaut mieux qu’un micro cher mal placé.
- ffmpeg, avec libass : pour le plateau, les coupes, les sous-titres et le rendu. Sur Mac, la formule ffmpeg-full de Homebrew l’a.
- Une transcription mot à mot : Whisper en local ou ElevenLabs Scribe : c’est la même qu’en face caméra.
- Tes visuels : des captures, des images, des logos : ce dont tu parles. Range-les dans un dossier, Claude les posera sur les mots.
- Un personnage, si tu en veux un : une planche de référence validée par toi, puis huit à douze poses. Voir plus haut pour le fabriquer.
Commence sans personnage : un mémo vocal, un plateau, trois captures posées sur les mots, un rendu. Le personnage vient quand la vidéo tient sans lui.
Ce qu’on en a fait : Pif Paf Cut
Cette méthode est dans la chaîne de montage que je vends : le faceless y est traité comme un rush. Tu déposes un mémo vocal ou une capture d’écran, elle fabrique le plateau, trie tes prises, pose tes visuels et rend, comme pour une vidéo face caméra.
- Le personnage en trois skills. « Crée mon personnage » pose les cinq questions et génère la planche ; « fais mes stickers » sort les poses, les détoure et les range avec leur catalogue ; « retouche mon personnage » change une tenue ou une expression sans en faire un autre, chaque version gardée.
- Codex, Gemini, ou tes images. La skill dit ce qui marche chez toi avant de générer quoi que ce soit, et ne demande jamais de clé dans la conversation.
- Les règles de montage sont écrites. Une pose par phrase, le miroir, le personnage qui s’efface, le buste qui sort du bas, un plateau nu signalé : c’est l’étage visuel qui les suit, pas toi qui les rappelles.
La chaîne complète, en prévente Le guide du montage face caméra Les skills gratuites
Questions fréquentes
Faut-il un générateur de vidéo IA pour faire du faceless ?
Non. Les générateurs vidéo (Veo, Kling, Sora…) facturent à la seconde, et chaque reprise coûte. Une vidéo faceless, c’est une voix et des images qui changent au bon moment : ffmpeg et Claude Code suffisent, sur ton abonnement.
Est-ce qu’il faut Codex ?
Non. C’est la voie la moins chère pour qui a déjà ChatGPT Plus, parce que les images y sont comprises. Sinon, une clé Gemini coûte moins d’un euro pour un personnage entier, et l’app Gemini gratuite marche à la main. Un personnage en SVG écrit par Claude ne coûte rien du tout.
Ma voix, ou une voix de synthèse ?
Ta voix. C’est ce qui rend la vidéo naturelle, et c’est gratuit. Une voix de synthèse (ElevenLabs) se paie au caractère et doit être déclarée comme contenu généré sur les plateformes. Elle a un sens si tu publies des dizaines de vidéos écrites, pas pour parler à ta place.
Le personnage peut-il me ressembler ?
Oui : une photo de toi, de face et bien éclairée, sert de référence, et tu choisis le style (dessin plat, 3D douce, collage papier…). Le résultat ressemble sans être parfait. Demande-toi si la ressemblance est voulue : pour un compte faceless, un personnage à part est souvent plus libre.
Et la bouche qui bouge quand je parle ?
Pas avec des images générées : le lip-sync se paie à la minute de vidéo, et le dessin dérive d’une image à l’autre. Une pose qui tient une ou deux secondes, un rebond à l’arrivée, et l’oreille fait le lien. Avec un personnage en SVG, la bouche peut suivre l’amplitude de ta voix, gratuitement.
Les images générées sont-elles à moi ?
Les conditions d’OpenAI et de Google te cèdent la sortie. Mais une image purement générée n’est probablement pas protégeable par le droit d’auteur : tu peux l’utiliser, pas forcément empêcher quelqu’un de la copier. Et ne pars jamais d’un personnage qui existe déjà (un héros connu, une mascotte de marque).
Combien de poses faut-il ?
Huit à douze au départ : neutre, explique, montre, surpris, content, réfléchit, doute, compte, non, rit. On ajoute à l’usage, quand une phrase n’a pas sa pose. Une grille générée en une passe garde mieux l’identité que douze images séparées.